株式会社スペースリー Railsエンジニアの大津です。
以前、150万レコードを持つ画像テーブルの移行という記事で物件画像テーブルの統合を紹介しました。あのテーブル群はその後も育ち続け、いまでは数百万行の画像テーブルや、1000万行を超えるテーブルもあります。
テーブルが育つと、ALTER TABLE が怖くなります。本記事では、正しく書いたつもりのマイグレーションで本番障害を2回起こしたことをきっかけに、オンラインスキーマ変更ツール gh-ost を導入した記録を紹介します。gh-ost 自体の解説は既に良い記事がいくつもありますが、Aurora MySQL で動かそうとすると、コミュニティ版 MySQL を前提にした記事には出てこない壁が次々に現れます。検索してもまとまった情報が少なかったので、つまずきどころを踏んだ順に書き残しておきます。
前提環境です。
- Rails 7.2(複数データベース構成)
- Aurora MySQL 3.04.1(MySQL 8.0.28互換)
- gh-ost v1.1.6
TL;DR
ALGORITHM=INPLACE, LOCK=NONEを明示しても、大きなテーブルへの ALTER で本番にエラーが出ました。LOCK=NONEが許可するのは DML の並行実行だけで、DDL の前後で取得される排他メタデータロックまでは避けられません- テーブルリビルドを伴う変更は gh-ost に切り替えました。ただし Aurora で動かすにはいくつもの壁がありました。特に「IAM データベース認証が使えない」「
binlog retention hoursが Terraform で管理できない」「別データベースからの外部キーで gh-ost が停止する」は、実際に踏むまで分かりませんでした - ツールを入れて終わりではなく、
INSTANTとの使い分け・strong_migrations との二段構え・リリースフローの調整までが導入でした
1. LOCK=NONE を指定したのに、本番が止まった
2026年1月、大量のレコードを持つ物件画像テーブルへのマイグレーションで、本番環境に同じ種類のエラーが2回発生しました。
ActiveRecord::StatementInvalid: Mysql2::Error: Table 'real_estates_db.real_estate_images' doesn't exist
テーブルを消したわけではありません。ALTER TABLE の実行中、対象テーブルが一時的に「存在しない」ものとして扱われ、そのテーブルを読み書きするクエリが失敗しました。エラーは約1分間続き、影響は画像を扱うサービス層、API レスポンスの生成(Jbuilder テンプレート)、アプリ向け API と広範囲に及びました。
1回目: ALGORITHM=INPLACE, LOCK=NONE を明示した PR
1回目(1月14日)は、画像の取り込み元を記録するカラムの追加でした。大きなテーブルであることは分かっていたので、MySQL のオンライン DDL を調べたうえで、生 SQL で ALGORITHM=INPLACE, LOCK=NONE を明示していました。
execute <<~SQL.squish
  ALTER TABLE `real_estate_images`
    ADD COLUMN `import_source` TINYINT AFTER `comment`,
    ALGORITHM=INPLACE, LOCK=NONE;
SQL
補足すると、カラムを既存カラムの隣へ挿入する AFTER 指定付きの追加は、MySQL 8.0.28(Aurora MySQL 3.04.1)では ALGORITHM=INSTANT が使えません(8.0.29以降で対応)。そのため INPLACE を選んでいました。LOCK=NONE は「並行して読み書きを許可せよ」という指定です。ドキュメントどおりに書けたと思っていましたし、レビューも通っています。それでも本番でエラーが出ました。
2回目: Rails 標準メソッドを使った PR
2回目(1月19日)は、同じカラムに NOT NULL 制約とデフォルト値を付ける変更で、今度は Rails の標準メソッドを使いました。
change_column_null :real_estate_images, :import_source, false
change_column_default :real_estate_images, :import_source, 0
結果は同じでした。同じエラーが、同じように約1分間。
「LOCK=NONE を明示した生 SQL」と「Rails の標準メソッド」という異なるアプローチで同じ障害が起きたため、個別の書き方の問題ではなく、大きなテーブルに MySQL のネイティブ ALTER を使うこと自体に限界があると判断しました。
2. なぜ標準のオンライン DDL では守れないのか
LOCK=NONE が守ってくれる範囲
調べて分かったのは、LOCK=NONE が許可するのは DML(INSERT / UPDATE / DELETE)の並行実行だけだということです。MySQL のドキュメントにあるとおり、オンライン DDL であっても処理の開始時と終了時には短時間の排他メタデータロック(exclusive metadata lock。以下、メタデータロックを MDL と書きます)を取得します。ここは LOCK=NONE でも回避できません。
排他 MDL 自体は短時間です。厄介なのは MDL の待ち行列のほうで、MDL の獲得要求は順番に処理されるため、先行する長いクエリが共有 MDL を持っていると、排他 MDL を待つ ALTER がその後ろに並び、さらにその後ろに、本来なら即座に実行できるはずの通常の SELECT や UPDATE までもが並んでしまいます。
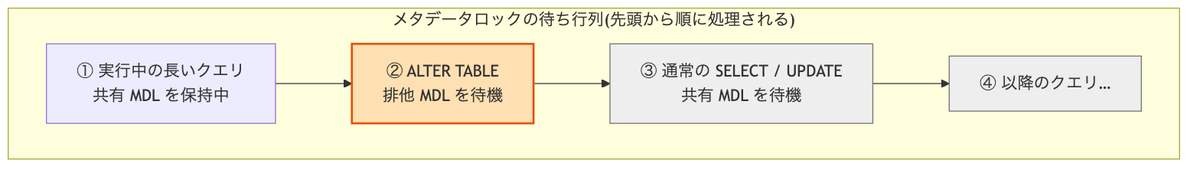
排他 MDL を待つ ALTER が行列に入ると、本来すぐ実行できるはずの後続クエリまで、その後ろで止まります。
また、Rails の change_column_null などの標準メソッドは ALGORITHM や LOCK を指定できません。NOT NULL 化はリビルドを伴う INPLACE で実行されるので、2回目の障害も機序は1回目と同じです。一方、カラムの型変更のように INPLACE が使えない操作では、書き込みをブロックする ALGORITHM=COPY(全行コピーして最後に入れ替える方式)が黙って選ばれます。標準メソッドは、どのアルゴリズムで走るかを制御できないこと自体が大きなテーブルでは怖さになります。
正直に書くと、今回の Table doesn't exist が MySQL 内部のどの処理で発生したのか、断定できるだけの裏取りはできていません。確実に言えるのは観測した事実、つまり リビルドを伴う ALTER の実行中に、対象テーブルへのクエリが約1分間失敗し続けたこと、そして ALGORITHM と LOCK を明示してもそれが起きたことです。
gh-ost は「最後の入れ替え方」が違う
gh-ost も「別のテーブルを作って最後に入れ替える」点は同じです。違うのは、その入れ替え方です。
gh-ost は元テーブルと同じ構造のゴーストテーブルを作って ALTER を適用し、元テーブルの行を少しずつコピーします。コピー中に元テーブルへ入った変更は binlog を読んで追従します。元テーブル自体には一切手を加えません。最後のカットオーバーは、次の1文です。
RENAME TABLE original TO _original_del, _original_gho TO original;
MySQL の RENAME TABLE は複数テーブルの入れ替えをアトミックに実行します。外部から「テーブルが存在しない瞬間」が観測されることはなく、MDL を保持する時間もごく短くて済みます。さらに gh-ost はカットオーバーの安全性に強くこだわっていて、入れ替えられる状態になるまで待ち、失敗すればやり直します。行コピーに何時間かかっても、その間アプリケーションからは元テーブルが普通に見えているだけです。
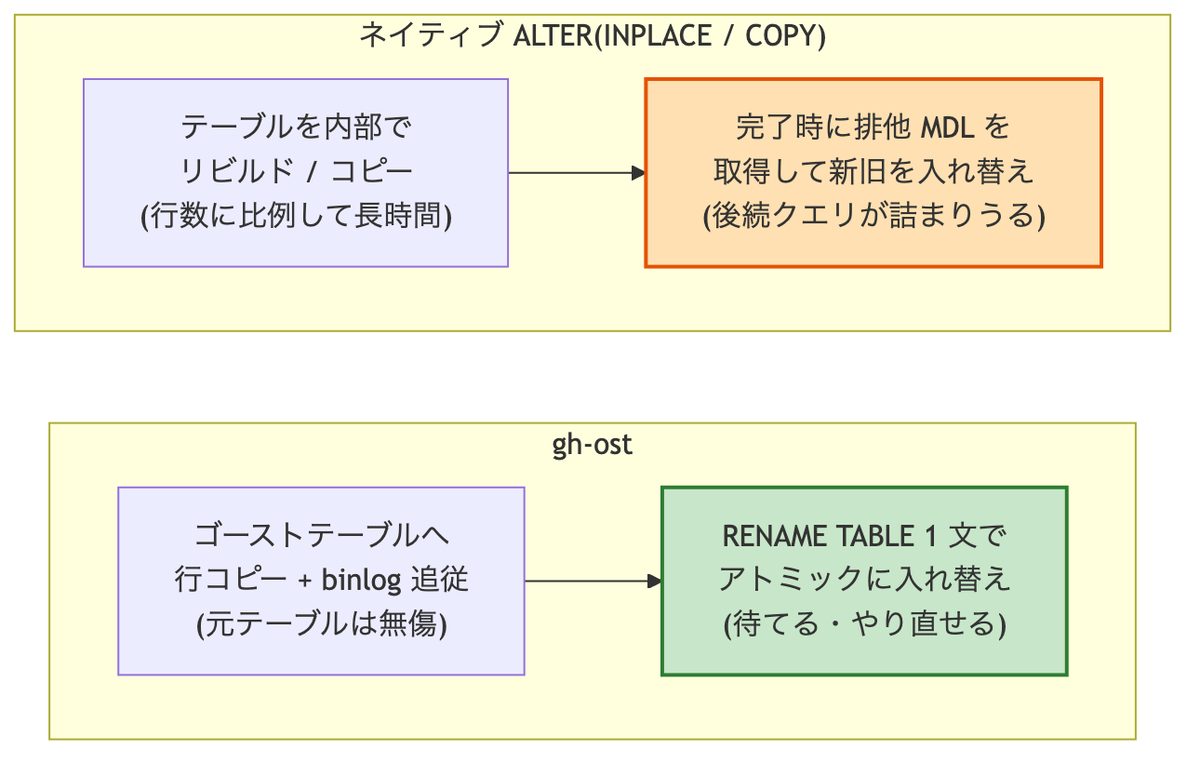
同じ「最後に入れ替える」でも、入れ替えの重さが違います。gh-ost の入れ替えは、いつでも実行・中断・再試行できる軽い操作に分離されています。
3. ツール選定: gh-ost か pt-online-schema-change か
本番運用で広く使われていて、メンテナンスが続いているオンラインスキーマ変更ツールは、実質 gh-ost(GitHub 製)と pt-online-schema-change(Percona 製)の2つでした。ほかにも候補はありましたが、以下の理由で採用しませんでした。
| ツール | 採用しなかった理由 |
|---|---|
| LHM(Shopify) | トリガーベースで pt-osc と同方式のため、比較は pt-osc に集約 |
| Spirit(Cash App) | 比較的新しく、Aurora MySQL での動作実績が少ない |
| fb-osc(Facebook) | Facebook 社内の MySQL 向け。リポジトリはアーカイブ済み |
| departure gem | pt-osc の Ruby ラッパー。Rails マイグレーションと密結合するため、手動実行の運用と相性が悪い |
gh-ost と pt-osc の比較で決め手になったのは2点です。
1つ目はトリガーレスであること。pt-osc は元テーブルに AFTER INSERT / UPDATE / DELETE のトリガーを作り、元テーブルへの書き込みのたびに新テーブルへの書き込みを追加します(書き込み増幅)。書き込みの多いテーブルでは、この追加負荷がそのままスループットに響きます。gh-ost は binlog を読んで追従するため、元テーブルへの書き込みに追加のオーバーヘッドがありません。
2つ目は、実行中に外から制御できること。gh-ost は実行中に Unix ソケットへコマンドを送ることで、一時停止・再開に加えて、チャンクサイズなどのパラメータまで動的に変更できます。pt-osc にも一時停止自体はありますが(--pause-file)、実行中のパラメータ変更はできず、トリガーは一時停止中も発火し続けるため元テーブルへの追加負荷は止まりません。数時間かかる移行を本番で流す前提では、「いざとなったら止めて様子を見られる」ことの価値は大きいと判断しました。
| 観点 | gh-ost | pt-online-schema-change |
|---|---|---|
| 変更の追従方式 | binlog ストリーミング | テーブルトリガー |
| 元テーブルへの影響 | なし(トリガーレス) | トリガーによる書き込みオーバーヘッド |
| 実行中の制御 | ソケット経由で一時停止・再開・パラメータ変更 | --pause-file で一時停止のみ(パラメータ変更は不可) |
| カットオーバー | アトミックな RENAME(タイミング制御・自動再試行あり) | アトミックな RENAME |
| 前提条件 | binlog_format=ROW、binlog の保持設定 | トリガー作成権限のみ |
あとで効いてくるのが、この表の最終行です。pt-osc が「Aurora 固有の設定なしで動く」のに対し、gh-ost は binlog まわりの前提を Aurora 側で整える必要があります。もっとも、この時点では「フラグを2つ足せば動くらしい」くらいの理解でいました。
4. Aurora で gh-ost を動かすまでに越えた壁
検証を進める中で踏んだ壁を、踏んだ順に並べます。先に一覧を置いておきます。
| # | 壁 | 対処 |
|---|---|---|
| 1 | 接続と権限の前提がコミュニティ版 MySQL と違う | --assume-rbr / --allow-on-master / TLS 接続 |
| 2 | IAM データベース認証が使えない | Secrets Manager からパスワード取得 |
| 3 | binlog の保持設定を IaC で管理できない | ストアドプロシージャで設定し、実行直前に確認する運用 |
| 4 | 外部キーがあるテーブルを拒否する | FK を記録してから外し、完了後に復元する |
| 5 | 別データベースからの外部キーで停止する | schema.rb だけでは気づけない |
| 6 | Rails の schema_migrations との整合が崩れる | gh-ost 実行 → INSERT → デプロイの順序を守る |
壁1: 接続と権限の前提がコミュニティ版 MySQL と違う
コミュニティ版 MySQL での gh-ost の標準的な使い方は「レプリカに接続して binlog を読み、本番のライターへの影響を最小化する」構成です。Aurora ではこれがそのまま通用せず、最初の接続までに3つの調整が要りました。
まず SUPER 権限。gh-ost は起動時に binlog_format=ROW を自分で保証しようとしますが、その変更に必要な SUPER 権限を Aurora では付与できないため、ここで失敗します。--assume-rbr フラグで「既に ROW である」ことを前提に変更をスキップさせ、前提そのものは事前に確認しておきます。
SHOW VARIABLES LIKE 'binlog_format';    -- 期待値: ROW
SHOW VARIABLES LIKE 'binlog_row_image'; -- 期待値: FULL
次に binlog の読み取り元です。Aurora のレプリケーションはストレージ層で行われており、リーダーインスタンスは MySQL ネイティブのレプリケーションで使う binlog を提供しません。そこで --allow-on-master を付けて、ライターに接続し binlog もそこから読む構成にします。読み取りの負荷がライターに乗ることは受け入れ、コピーの負荷は --max-load で抑えます。
最後は認証です。gh-ost 用の DB ユーザーは caching_sha2_password 認証で作成しています(Aurora MySQL 3のデフォルトはコミュニティ版8.0と異なり mysql_native_password のままで、ユーザー単位でのみ新しいプラグインを指定できます)。この認証はパスワードを保護された接続で送る前提の場面があり、RDS の CA 証明書バンドルを渡して TLS 接続にすることで通ります。--ssl-allow-insecure という名前に身構えますが、通信が平文になるわけではありません。TLS 接続自体は行ったうえで証明書の検証をスキップする、という意味です(今回の構成では、このフラグまで併用しないと接続できませんでした)。
# RDS の CA 証明書バンドルを取得
curl -sO https://truststore.pki.rds.amazonaws.com/ap-northeast-1/ap-northeast-1-bundle.pem
これらを合わせると、ドライラン(事前検証)のコマンドはこうなります。
./gh-ost \
  --host="$DATABASE_HOST" \
  --port=3306 \
  --user="$DATABASE_USER" \
  --password="$DATABASE_PASSWORD" \
  --ssl \
  --ssl-ca=ap-northeast-1-bundle.pem \
  --ssl-allow-insecure \
  --database=real_estates_db \
  --table=real_estate_images \
  --alter="MODIFY COLUMN import_source TINYINT NOT NULL DEFAULT 0" \
  --assume-rbr \
  --allow-on-master \
  --chunk-size=1000 \
  --max-load=Threads_running=25 \
  --critical-load=Threads_running=100 \
  --verbose
| フラグ | 意味 |
|---|---|
--assume-rbr |
binlog_format=ROW を前提とし、変更を試みない(SUPER 権限が不要になる) |
--allow-on-master |
ライターに接続し、binlog もそこから読む |
--ssl 系3つ |
TLS で接続する(caching_sha2_password 対策) |
--chunk-size |
1回にコピーする行数 |
--max-load |
超えたらコピーを一時停止する負荷のしきい値 |
--critical-load |
超えたら処理を中断するしきい値 |
--ok-to-drop-table |
完了時に旧テーブル(_del)を自動 DROP する(本番実行時に付与。デフォルトでは DROP せず残す) |
--execute |
付けると本番実行。付けなければドライラン |
--execute を付けない場合、接続・権限・binlog 読み取りの検証とゴーストテーブルの作成までを行い、実際の変更はせずに片付けて終了します。元テーブルには影響がないので、本番でも安心して流せる確認手段です。
壁2: IAM データベース認証が使えない
ここは失敗談です。
弊社では、人が DB に接続するときは IAM データベース認証を使っており、gh-ost も当然そこに乗せるつもりでいました。パスワードを配布せずに済み、権限を IAM に集約できるからです。インフラチームに gh-ost 用 DB ユーザーへの rds-db:connect 権限の付与を依頼し、対応してもらいました。
その後の検証で、gh-ost は IAM 認証では接続できないことが分かりました。当時インフラチームに送った報告の要旨です。
gh-ost の検証を進めたところ、gh-ost の DB 接続には IAM 認証が使えないことが分かりました。事前の調査が不十分で、せっかく
rds-db:connectの権限付与を対応いただいたのにすみません。原因は、gh-ost が内部で MySQL のレプリケーションプロトコルを使って binlog を読み取るためです。
gh-ost は通常の SQL クライアントとして接続するだけでなく、binlog を読むためにレプリカのふりをしてレプリケーションプロトコルを話します。この接続は IAM 認証に対応していません。ツールの README と主要なフラグは読んでいたのですが、「接続の内側でどのプロトコルを話すか」までは見ていませんでした。認証方式の検証は、権限付与を依頼する前にやるべきでした。
結果として、gh-ost 用 DB ユーザー(ここでは ghost_user と呼びます。ツール名と紛らわしいので、実際の運用では別の名前をお勧めします)のパスワードは Secrets Manager に置き、実行時に取得する構成にしました。
export GH_OST_PWD=$(aws secretsmanager get-secret-value \
  --secret-id <gh-ost 用パスワードのシークレット名> \
  --query SecretString --output text)
ちなみに、後述する RDS のストアドプロシージャ実行や外部キー操作に使う運用ユーザー(壁3・壁4に出てくる ops_user)のほうは、通常の SQL クライアント接続なので IAM 認証のままです。こうして 1回の gh-ost 作業の中に、IAM 認証で接続するユーザーとパスワードで接続するユーザーが混在します。構成としてはやや不格好ですが、この制約が存在する以上、これが現実的な回避策でした。
壁3: binlog の保持設定は IaC で管理できない
gh-ost は binlog を読み続けて変更を追従するため、実行中に binlog が消えると続行できません。一方 Aurora はデフォルトでは binlog の保持を保証しないので、保持時間を明示する必要があります。
コミュニティ版 MySQL なら binlog_expire_logs_seconds をパラメータで設定するところですが、Aurora にはこれに相当するパラメータが、クラスタパラメータにもインスタンスパラメータにも存在しません。設定手段はストアドプロシージャだけです。
-- 確認
CALL mysql.rds_show_configuration;

-- 24 時間保持に設定
CALL mysql.rds_set_configuration('binlog retention hours', 24);
これはつまり、Terraform で宣言できない設定だということです。値は mysql スキーマ配下のテーブルに保存され、パラメータグループとは別のレイヤで管理されます。なお、このプロシージャの実行には EXECUTE 権限が必要で、ghost_user には持たせていないため、壁2に出てきた運用ユーザー ops_user(IAM 認証)で実行します。
導入当初は、gh-ost 実行の直前に24時間へ設定し、完了後に NULL(デフォルト)へ戻す運用にしていましたが、しばらくして常時24時間保持に変えました。設定し忘れたまま実行すると、binlog が purge された時点で gh-ost が FATAL Error reading from binlog で停止し、数時間走った移行でも最初からやり直しになります。「戻し忘れ」より「設定し忘れ」のほうがずっと怖いです。常時保持のコストは実測で確認していて、保持される binlog は最大でも7.94 GB(クラスタボリュームの0.83%)、ストレージ費の増分は月 \$1〜2でした。保持設定は「既に書かれている binlog をいつ消すか」を変えるだけなので、書き込み性能への影響もありません。
この設定は Blue/Green デプロイなど「クラスタが新しく作られる」操作では引き継がれません。IaC で宣言できない以上、こうした経路をすべて塞ぐことは諦め、gh-ost の手順書の先頭に「保持設定を確認し、24時間未満なら設定する」というステップで担保することにしました(ほぼ発火しない定期監視は、いざというときに機能しないと考えて入れていません)。
壁4: 外部キーがあるテーブルを gh-ost は拒否する
外部キー(FK)が絡むテーブルに gh-ost をかけると、ドライランの段階で停止します。テーブルを丸ごと入れ替えるという方式の性質上、gh-ost は FK の付け替えを安全に扱えないため、FK を検出すると原則として実行を拒否します。
対応は、対象テーブルの立場によって変わります。
- 親テーブル(他のテーブルから参照されている側): 子テーブル側の FK をいったん DROP し、gh-ost の完了後に再追加する
- 子テーブル(FK を持っている側):
--discard-foreign-keysフラグで FK を捨てて実行し、完了後に手動で再追加する
--discard-foreign-keys は名前のとおり、カットオーバー後のテーブルから FK が消えた状態になるフラグです。「あとで自分で戻す」ことまで含めて1セットと考える必要があります。
FK の DROP と再追加には REFERENCES 権限が必要で、これも ghost_user には持たせていないため、binlog の保持設定と同じく ops_user で行います。
FK を外して戻す以上、戻すときに元と完全に同じ状態へ復元する必要があります。具体的には制約名と ON DELETE ルールです。制約名が変わると Rails の schema.rb と実際のスキーマが乖離します。ON DELETE を取り違えると、親レコードを削除したときの挙動(子も消えるのか、NULL になるのか、削除自体が失敗するのか)が変わってしまいます。
そこで、外す前に information_schema から現状を記録しておきます。
SELECT
  tc.CONSTRAINT_NAME,
  tc.TABLE_NAME AS child_table,
  kcu.COLUMN_NAME AS fk_column,
  kcu.REFERENCED_TABLE_NAME AS parent_table,
  rc.DELETE_RULE
FROM information_schema.TABLE_CONSTRAINTS tc
JOIN information_schema.KEY_COLUMN_USAGE kcu
  ON tc.CONSTRAINT_NAME = kcu.CONSTRAINT_NAME
  AND tc.TABLE_SCHEMA = kcu.TABLE_SCHEMA
JOIN information_schema.REFERENTIAL_CONSTRAINTS rc
  ON tc.CONSTRAINT_NAME = rc.CONSTRAINT_NAME
  AND tc.TABLE_SCHEMA = rc.CONSTRAINT_SCHEMA
WHERE tc.TABLE_SCHEMA = 'real_estates_db'
  AND kcu.REFERENCED_TABLE_NAME = 'real_estate_images'
  AND tc.CONSTRAINT_TYPE = 'FOREIGN KEY';
実は、このクエリの WHERE 句には後から気づく問題が1つ残っています(壁5で説明します)。
実際にあるテーブルで調べたところ、参照している子テーブルの FK には CASCADE、SET NULL、RESTRICT(指定なしのデフォルト)が混在していました。同じテーブルを参照する3本の FK がそれぞれ違う削除ルールを持っている、というのは記録して初めて意識しました。
再追加の前に、FK が外れていた間に親のいない子レコードが生まれていないかを確認します。
SELECT COUNT(*) FROM image_ai_generations
WHERE real_estate_image_id NOT IN (SELECT id FROM real_estate_images);
-- 0 であること
問題がなければ、記録どおりに再追加します。ここにも気をつけたい点があり、FK を追加する ALTER は foreign_key_checks が有効のままだと COPY(テーブルコピー)でしか実行できません。子テーブルが大きいと、避けたかったはずの長時間 ALTER がここで発生します。そこでセッションの foreign_key_checks を無効にして INPLACE で追加します。この場合 MySQL は既存行を検証しないため、直前の確認クエリが「あれば安心」ではなく必須の手順になります。
SET SESSION foreign_key_checks = 0;

ALTER TABLE image_ai_generations
  ADD CONSTRAINT fk_image_ai_generations_image_id
  FOREIGN KEY (real_estate_image_id)
  REFERENCES real_estate_images(id) ON DELETE CASCADE,
  ALGORITHM=INPLACE, LOCK=NONE;

ALTER TABLE image_ai_generations
  ADD CONSTRAINT fk_image_ai_generations_source_image_id
  FOREIGN KEY (source_real_estate_image_id)
  REFERENCES real_estate_images(id) ON DELETE SET NULL,
  ALGORITHM=INPLACE, LOCK=NONE;

ALTER TABLE temporary_processing_images
  ADD CONSTRAINT fk_temporary_processing_images_image_id
  FOREIGN KEY (real_estate_image_id)
  REFERENCES real_estate_images(id),  -- ON DELETE 指定なし = RESTRICT
  ALGORITHM=INPLACE, LOCK=NONE;

SET SESSION foreign_key_checks = 1;
ALGORITHM=INPLACE を明示しているのは、foreign_key_checks の無効化を忘れたときに、黙って COPY へフォールバックせずエラーで止めるためのガードです。
壁5: schema.rb に見えない外部キー
個人的には、ここがいちばんの壁でした。
対象は、ここまでの画像テーブルとは別のデータベース(アプリのメイン DB。記事では app_db とします)にある、1000万行規模のテーブルからの不要カラム削除です。前述のとおり Aurora MySQL 3.04.1(8.0.28互換)は DROP COLUMN の INSTANT 実行に対応していない(8.0.29以降の機能)ので、リビルドを避けるなら gh-ost の出番です。ところが、ドライランを流すと gh-ost が停止しました。
Parent-side foreign keys are not supported. Bailing out
「このテーブルは他のテーブルから FK で参照されている(親テーブルである)ため実行できない」というメッセージです。
このメッセージには混乱しました。Rails の schema.rb を見ても、このテーブルを参照している外部キーは存在しないのです。壁4のクエリで information_schema を確認したときも(当時の書き方では)何も出てきませんでした。
正体は、別のデータベースにある子テーブルからの、クロスデータベース外部キーでした。弊社の Rails アプリは複数データベース構成で、アクセス解析系のデータは analytics_db という別のデータベースに分かれています。その analytics_db 側のテーブル2つが、app_db 側のこのテーブルを FK で参照していました。
Rails では、この FK の定義は db/schema.rb ではなく、もう一方のデータベースのスキーマファイルにあります。
# db/analytics_schema.rb(analytics_db 側のスキーマファイル)
add_foreign_key "interest_panels", "panels"
add_foreign_key "interest_popups", "panels"
db/schema.rb だけを見て「FK なし」と判断していたのが敗因です。information_schema のクエリも、子テーブル側のスキーマ(tc.TABLE_SCHEMA)で絞っていたため、別データベースにいる子テーブルの FK を検出できていませんでした。参照される側のスキーマで絞るのが正解です。
-- ❌ Bad: 子テーブル側のスキーマで絞ると、別 DB からの FK を見落とす
WHERE tc.TABLE_SCHEMA = 'app_db'
  AND kcu.REFERENCED_TABLE_NAME = 'panels'

-- ✅ Good: 参照される側のスキーマで絞る
WHERE kcu.REFERENCED_TABLE_SCHEMA = 'app_db'
  AND kcu.REFERENCED_TABLE_NAME = 'panels'
なお --discard-foreign-keys は子テーブル側の FK 専用のフラグなので、この状況(親側 FK)には効きません。親である以上、対応は壁4と同じです。参照している側の FK(今回は別データベースにある2本)を記録して外し、gh-ost の完了後に元どおりに戻すことになります。
壁6: Rails の schema_migrations とどう噛み合わせるか
最後は Rails との統合です。スキーマ変更を gh-ost で行うということは、rails db:migrate の外側でスキーマが変わるということです。何も考えないと、Rails のマイグレーション管理(schema_migrations テーブル)と実際のスキーマがずれていきます。
検討の結果、マイグレーションファイルはこう書くことにしました。
class AddNotNullToImportSourceOnRealEstateImages < ActiveRecord::Migration[7.2]
  # Run via gh-ost in production. Runs directly in local/CI.
  # gh-ost command:
  #   gh-ost --database=real_estates_db --table=real_estate_images \
  #     --alter="MODIFY COLUMN import_source TINYINT NOT NULL DEFAULT 0" \
  #     --assume-rbr --allow-on-master --ok-to-drop-table --execute

  def up
    execute <<~SQL.squish
      ALTER TABLE `real_estate_images`
        MODIFY COLUMN `import_source` TINYINT NOT NULL DEFAULT 0,
        ALGORITHM=INPLACE,
        LOCK=NONE;
    SQL
  end

  def down
    execute <<~SQL.squish
      ALTER TABLE `real_estate_images`
        MODIFY COLUMN `import_source` TINYINT DEFAULT NULL,
        ALGORITHM=INPLACE,
        LOCK=NONE;
    SQL
  end
end
この書き方の意図は2つあります。
- 実際の ALTER 文を書く(空のマイグレーションにしない)。ローカルと CI はレコードが少ないので、通常の
rails db:migrateでこの ALTER をそのまま流して問題ありません。空にしてしまうと、ローカルのスキーマが本番と一致しなくなります - gh-ost コマンドの全文をコメントで残す。本番の作業者がここからコピーして実行する想定です
本番系への適用は、環境ごとに次の順序で行います(integration → staging → production の順で同じ手順を繰り返します)。
- gh-ost でスキーマ変更を実行する
schema_migrationsにバージョンを手動で INSERT する
INSERT INTO schema_migrations (version) VALUES ('20260630000001');
- デプロイする。
rails db:migrateは該当バージョンを適用済みとみなしてスキップする
この順序が崩れると事故になります。gh-ost の実行前にデプロイしてしまうと、rails db:migrate がマイグレーションファイル内の ALTER を、そのまま本番の大きなテーブルに実行します。つまり1月に発生した障害とまったく同じことをもう一度やることになる。マイグレーションに実 ALTER を書く方式の代償がこれで、gh-ost 対象の PR には「⚠️ gh-ost 実行前にデプロイしないこと」を必ず明記するようにしています(この制約が生む摩擦については、最後にもう一度触れます)。
長時間の実行をどう回すか
壁というより運用の話ですが、実行環境にも1つ落とし穴があるので触れておきます。
弊社は ECS(Fargate)構成で、運用作業用のタスクに ECS Exec で入り、Go 製シングルバイナリの gh-ost をタスク上にダウンロードして実行します。このとき、ECS Exec のセッションにはアイドルタイムアウト(20分)があり、これを変更できません。数時間かかる gh-ost をフォアグラウンドで流すと、セッションの切断と一緒に gh-ost まで終了してしまいます。
対処は古典的で、nohup でバックグラウンドへ逃がしてログをファイルに書きます。本番実行のコマンドはドライランに --ok-to-drop-table --execute を足した形です。--ok-to-drop-table は、カットオーバー後に残る旧テーブル(_<テーブル名>_del)を自動で DROP させるフラグです。テーブルの DROP は長いロック操作になりうるという理由で gh-ost はデフォルト無効にしているので、影響が読めない環境では付けずに、後から手動で DROP するほうが安全側です。
LOG_FILE="gh-ost-real_estate_images-$(date +%Y%m%d_%H%M%S).log"

nohup ./gh-ost \
  --user=ghost_user --password="$GH_OST_PWD" \
  ...(ほかはドライランと同じフラグ)... \
  --ok-to-drop-table \
  --execute > "$LOG_FILE" 2>&1 &

echo "gh-ost PID: $!"
セッションが切れても gh-ost は生き続け、再接続後は tail -f と、gh-ost が開く Unix ソケットで様子を見ます。
tail -f gh-ost-real_estate_images-*.log

# ソケット経由で状態確認(コンテナに nc が無いため python で)
SOCKET=/tmp/gh-ost.real_estates_db.real_estate_images.sock
python3 -c "import socket; s=socket.socket(socket.AF_UNIX,socket.SOCK_STREAM); s.connect('$SOCKET'); s.sendall(b'status\n'); print(s.recv(4096).decode()); s.close()"
同じソケットに throttle(一時停止)、no-throttle(再開)、chunk-size=500(チャンクサイズ変更)を送ると、実行中の gh-ost を外から制御できます。ツール選定の決め手にした「実行中に制御できる」は、この形で使っています。進捗はログに次の形式で流れ、コピー済み行数・ETA・binlog 追従の遅れ(Lag)・未処理イベント数(Backlog)が1行で見えます(値は出力例です)。
Copy: 1500000/3140000 47.8%; Applied: 234; Backlog: 0/1000; Time: 12m30s(total), 12m30s(copy); streamer: binlog.000123:456789; Lag: 0.02s, HeartbeatLag: 0.05s, State: migrating; ETA: 13m42s
5. 運用に乗せるまで
100万行のテストテーブルで検証する
いきなり本番のテーブルに使う前に、integration 環境で一通りの動きを検証しました。ただ、integration の実テーブルは本番よりずっと小さく、行コピーの進捗・スロットリング・ETA の精度といった「大きいテーブルでこそ意味のある挙動」を確認できません。そこで検証専用のテーブルを作り、自己 SELECT の倍々 INSERT で約100万行まで膨らませて使いました。
CREATE TABLE gh_ost_load_test (
  id BIGINT NOT NULL AUTO_INCREMENT,
  data VARCHAR(255) NOT NULL DEFAULT '',
  category INT NOT NULL DEFAULT 0,
  created_at DATETIME(6) NOT NULL DEFAULT CURRENT_TIMESTAMP(6),
  updated_at DATETIME(6) NOT NULL DEFAULT CURRENT_TIMESTAMP(6),
  PRIMARY KEY (id),
  KEY idx_category (category)
) ENGINE=InnoDB;

INSERT INTO gh_ost_load_test (data, category) VALUES ('seed', 1);

-- 自分自身から SELECT して倍々に増やす(20 回で約 100 万行)
INSERT INTO gh_ost_load_test (data, category, created_at, updated_at)
SELECT CONCAT('test-', id), FLOOR(RAND() * 100), NOW(6), NOW(6)
FROM gh_ost_load_test;
このテーブルとその他の小さな実テーブルを使って、以下の観点を確認しました。
- ドライランから本番実行までの一連の流れ
- 負荷スロットリング(
--max-load)の発動と ETA 表示の妥当性 - 途中で kill したときの挙動: 元テーブルが無傷であること、残ったゴーストテーブル(
_gho/_ghc)を手動で片付けて再実行できること - FK の DROP → gh-ost → 再追加という完全なサイクル(壁4)
schema_migrationsへの手動 INSERT でrails db:migrateがスキップされること(壁6)
特に中断からの復旧は、事前に一度手を動かしておいて良かったと思います。本番で初めてやるのとでは落ち着きが違います。
本番初回は「消すためのカラム」で
本番の初回実行は、実際に必要なスキーマ変更ではなく、検証専用のカラムを1本足して、翌日それを消すという形にしました。画像テーブルの1つに _gh_ost_verification という TINYINT カラムを追加し(追加も削除も gh-ost で行います)、手順全体を本番環境で通しで確認してから、実際に必要な変更に進みました。
検証専用カラムなら、もし何か起きても誰も参照していないので実害がありません。6月末にこのマイグレーションを用意し、7月頭に staging → production の順で初実行しています。
入口を塞ぐ: strong_migrations は素のままでは使えなかった
gh-ost は「危険な変更を安全に実行する出口」ですが、そもそも危険な変更が気づかれないまま本番に向かわないようにする入口も必要です。そこで strong_migrations を導入しました。危険なマイグレーションを rails db:migrate の時点で検出してブロックし、安全な代替手順を提示してくれる gem です。
ただ、素のまま入れたら使いものになりませんでした。導入前に、2024年以降の既存マイグレーション226件に対して「もし strong_migrations が入っていたら」を検証したところ、
- ブロックされるのは57件(25.2%)
- そのうち61%(35件)は誤検知
でした。誤検知の内訳は主に2つです。1つは change_table bulk: true(インデックスをまとめて張るための安全な用途)で、strong_migrations はブロックの中身を検査できないため一律に警告します。もう1つは、意図的に ALGORITHM=INPLACE, LOCK=NONE を明示した execute、つまり安全側に倒して書いた生 SQL です。安全のために書いた SQL が危険と判定されるのでは本末転倒です。
4件に1件のマイグレーションが止められ、その6割が誤検知という状態で運用を始めれば、チームは確実に safety_assured(チェックをスキップするラッパー)を反射で書くようになります。lint は、入れ方を間違えると即座に無視される道具になります。
最終的な設定はこうなりました。
# config/initializers/strong_migrations.rb

# Skip checks for all migrations created before this PR was merged.
StrongMigrations.start_after = 20260526000000

# Aurora MySQL 8.0 (8.0.28 compatible via Aurora 3.04.1).
StrongMigrations.target_version = "8.0"

# Run ANALYZE TABLE after adding indexes to refresh optimizer statistics.
StrongMigrations.auto_analyze = true

# Disable checks with high false-positive rates for MySQL.
StrongMigrations.disable_check(:change_table)
StrongMigrations.disable_check(:execute)
誤検知の大半を占めた2つのチェックを無効化し、start_after で既存マイグレーションを対象外にしています。target_version は、開発環境の DB バージョンに関わらず、本番のバージョンを基準にチェックさせるための設定です。
検討したうえで採用しなかった設定もあります。
lock_timeout/statement_timeout: MySQL のmax_execution_timeは SELECT にしか効かず、DDL には効きません。lock_wait_timeoutを短くする案は、正当なマイグレーションまで落とすリスクがあり見送りましたalphabetize_schema:schema.rb全体のカラム順が変わって巨大な差分が出るため見送りましたsafe_by_default: PostgreSQL 向けの機能で、MySQL には対応する安全化パスがありません
1つ注意があるとすれば、:execute チェックを無効化したことで、生 SQL は strong_migrations の監視対象外になります。gh-ost 用マイグレーションが生 SQL で実 ALTER を書く運用(壁6)とは相性が良い一方、生 SQL の安全性はレビューと規約で担保することになります。ここはトレードオフを認識したうえでの判断です。
使い分けの基準と、チームへの定着
gh-ost が入っても、すべてのスキーマ変更を gh-ost にするわけではありません。判断の流れはおおよそ図のとおりです。
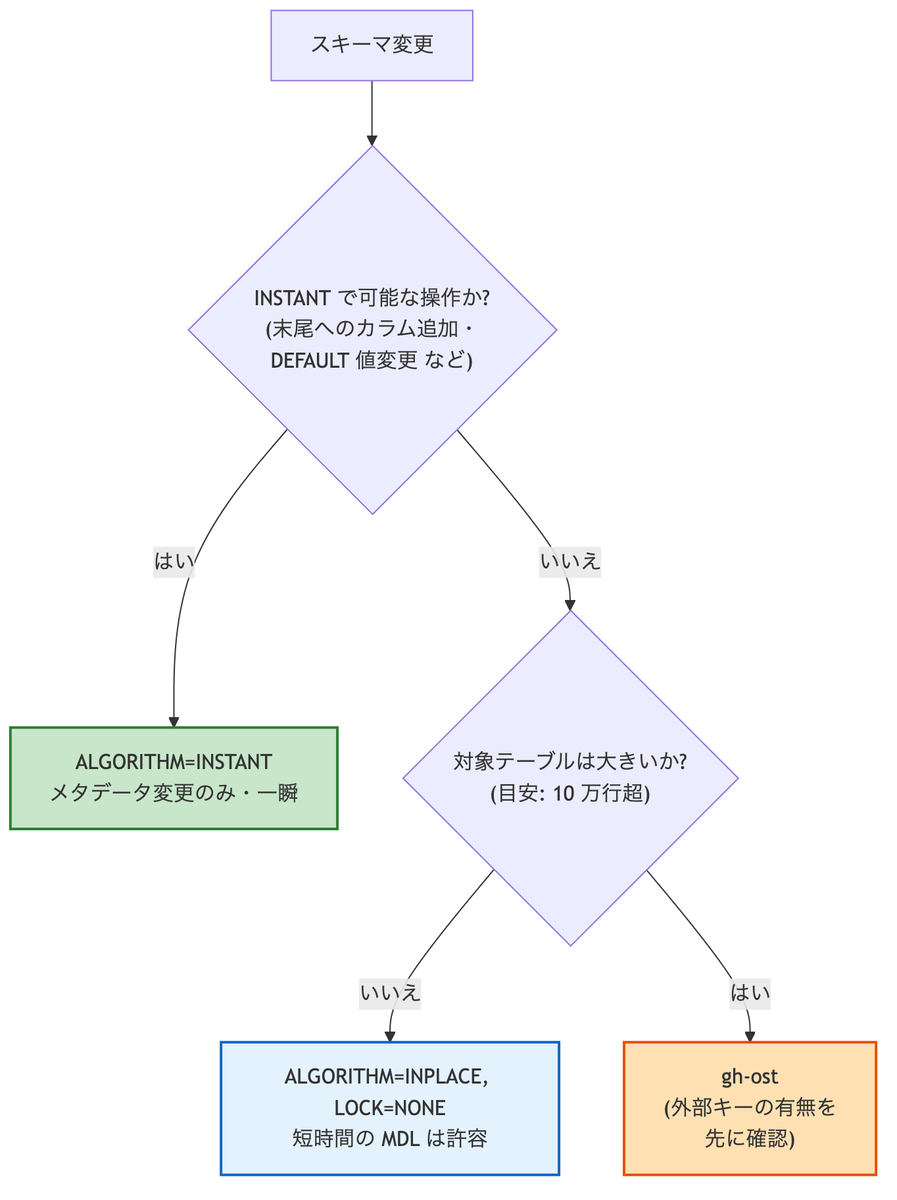
まず INSTANT を検討し、ダメならテーブルの大きさで分岐します。gh-ost は「INSTANT にできない変更 × 大きなテーブル」のときの手段です。
実際にこの使い分けが機能した例があります。画像テーブル(約600万行)に MD5ダイジェストのカラムを追加したときは、gh-ost を使わず ALGORITHM=INSTANT で実行しました。末尾への NULL 許容カラムの追加は MySQL 8.0.12以降 INSTANT の対象で、テーブルサイズに関係なくメタデータ変更だけで一瞬で終わるからです。マイグレーションには判断理由をコメントで残しています。
class AddMd5DigestToRealEstateImages < ActiveRecord::Migration[7.2]
  # Run via ALGORITHM=INSTANT in production (metadata-only change, no table rebuild or lock).
  # For tables where gh-ost is typically used, INSTANT is safe here because:
  #   - Adding a NULLable column at the end of the table
  #   - MySQL 8.0.12+ supports INSTANT for this operation

  def up
    execute <<~SQL.squish
      ALTER TABLE `real_estate_images`
        ADD COLUMN `md5_digest` VARCHAR(32) DEFAULT NULL,
        ALGORITHM=INSTANT;
    SQL
  end

  def down
    execute <<~SQL.squish
      ALTER TABLE `real_estate_images`
        DROP COLUMN `md5_digest`,
        ALGORITHM=INPLACE,
        LOCK=NONE;
    SQL
  end
end
あとは、チームにどう定着させるかです。やったことは3つです。
- PR の規約を作る: gh-ost 対象の PR には、ドライラン用と本番用のコマンド全文、FK 対応の SQL、環境ごとの適用手順、「⚠️ gh-ost 実行前にデプロイしないこと」の警告を本文に書きました
- 危険な変更は PR を分割する: 上記の MD5カラムの例では、①カラム追加(INSTANT)→ ②アプリコード → ③バックフィルの Rake タスク → ④インデックスと NOT NULL 制約(gh-ost)の4本に分けました
- 社内勉強会で仕組みから共有する: 手順だけでなく、「なぜネイティブ ALTER で障害が起きるのか」「gh-ost は何が違うのか」という仕組みの部分から説明しました
導入から1か月ほど経ったころ、別のメンバーが自分の PR に対して「このテーブルは大きいので gh-ost で対応しましょうか」と提案してくれるようになりました。ツールが「導入した人の作業」から「チームの選択肢」になった瞬間で、個人的にはここが導入の完了地点だったと思っています。
6. 残っている課題
gh-ost の導入で、新しい種類のコストも生まれています。
いちばん大きいのはリリースフローとの摩擦です。壁6のとおり、gh-ost 対象の PR には「gh-ost 実行前にデプロイしてはいけない」という順序の制約があります。弊社ではマージがデプロイにつながるため、これは「レビューが承認されても、gh-ost の実行枠を確保できるまでマージできない」ことを意味します。実際、承認済みの gh-ost 対象 PR が数週間 open のまま、という状態が起きています。レビューが滞っているというより、仕組み上そうなってしまう、というのが正確なところです。
ほかにも課題は残っています。
- 「いっそすべてのマイグレーションを gh-ost で流せないか」という議論はありますが、外部キー対応の自動化とリリースフローの再設計が必要で、結論は出ていません
- 行数が少ないため gh-ost の対象外と判断したマイグレーションが、リリース時に約30秒かかって日中のサービスに影響した件もありました。「どこからが大きいテーブルか」の線引きは、まだ手探りです
- メンテナンスモード(計画停止)を使えば話は単純になりますが、サービス特性上ハードルが高く、現実的ではありません
深夜のメンテナンス作業をなくすために入れたツールが、代わりに「調整」という別のコストを生んだ、というのが導入後の実感です。それでも、本番が止まらないことには代えられません。1月に発生したような障害はそれ以来起きていませんし、大きなテーブルへの変更を「怖いから先送りする」ではなく「手順に乗せて安全に実行する」に変えられたことが、いちばんの成果だと考えています。
7. まとめ
LOCK=NONEは「並行 DML の許可」であって、無停止の保証ではありません。排他メタデータロックとその待ち行列は回避できず、リビルドを伴う ALTER は大きなテーブルで本番を止めることがあります- Aurora で gh-ost を動かす最小構成は「
--assume-rbr+--allow-on-master+ TLS 接続」、そしてbinlog retention hoursの設定です。ただし IAM データベース認証は使えず、binlog 設定は Terraform 管理外で Blue/Green デプロイでも消えるなど、コミュニティ版 MySQL には無い制約が随所にあります - 外部キーは
schema.rbだけで判断しないこと。複数データベース構成では、別 DB のスキーマファイルにだけ現れるクロスデータベース FK があり、information_schema の確認も「参照される側」のスキーマで絞る必要があります - ツールの導入は、ツールが動いた時点では終わりません。
INSTANTとの使い分け、strong_migrations との二段構え(入口と出口)、リリースフローとの調整、そしてチームのメンバーが自分から選べるようになるまでが導入でした
参考
- gh-ost — command-line flags / cut-over の解説
- MySQL 8.0: Online DDL Operations / Online DDL Performance and Concurrency / Metadata Locking
- Setting and showing binary log configuration — Amazon Aurora
- Best practices for upgrading Amazon RDS for MySQL 8.0 to 8.4(AWS Database Blog) — Blue/Green と binlog retention の関係
- strong_migrations
Spacely では、Rails / Aurora MySQL を中心としたバックエンド開発を行っており、今回のようなデータベース運用の課題をチームで議論しながら日々改善しています。こうした課題を一つずつ改善していく仕事に興味がある方と、一緒により良いプロダクトを作っていけたら嬉しいです。
